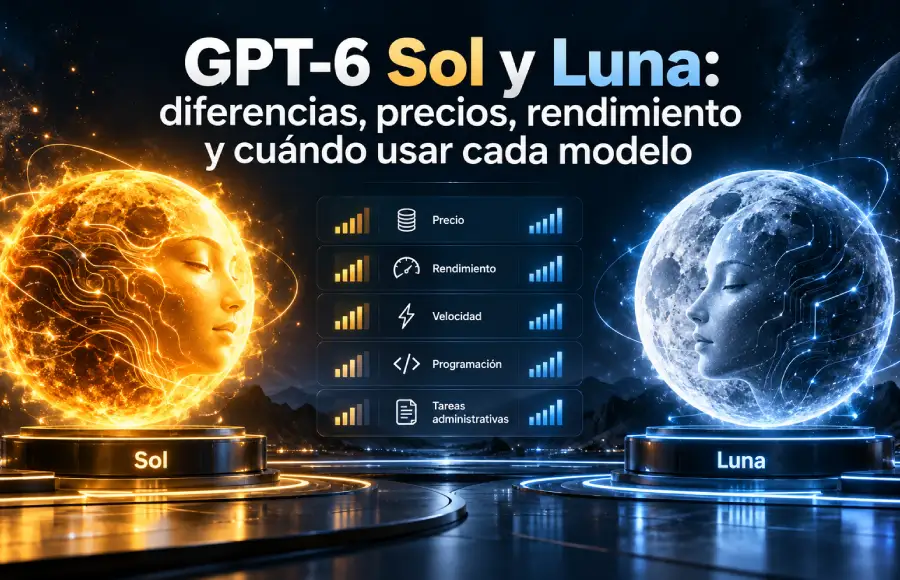
La llegada de GPT-6 Sol y Luna me parece bastante más interesante de lo que podría parecer a simple vista.
Cuando OpenAI presentó esta nueva generación, GPT-6 Astra tenía todas las papeletas para llevarse los titulares. Es lógico: representa el nivel más alto de la familia y es el modelo diseñado para afrontar los problemas más exigentes. Sin embargo, cuando pienso en cómo utilizamos realmente la inteligencia artificial todos los días, Sol y Luna podrían acabar teniendo un impacto incluso mayor.
La razón es sencilla: no necesitamos utilizar siempre el modelo más potente disponible.
Para resumir un documento, clasificar información o extraer varios campos de una base de datos, recurrir al modelo más avanzado puede ser innecesario. Y, en el extremo contrario, hay tareas de programación, razonamiento o automatización donde sí necesitamos bastante capacidad, pero donde pagar continuamente por el modelo tope de gama tampoco tiene demasiado sentido.
Ahí es donde empiezan a encajar Sol y Luna.
OpenAI ha planteado GPT-6 como una familia con distintos niveles. Astra ocupa la parte superior; Sol busca un equilibrio entre capacidad y coste; y Luna prioriza especialmente la eficiencia para trabajos rápidos y de gran volumen. OpenAI también ha reducido de forma considerable las tarifas API respecto a sus equivalentes GPT-5.6.
Para mí, esta es precisamente una de las grandes ideas detrás de esta generación:
la eficiencia empieza a ser casi tan importante como la inteligencia.
Y eso cambia bastante la conversación.
Ya no basta con preguntarnos cuál es el modelo más inteligente. También tenemos que preguntarnos cuánta inteligencia necesitamos para resolver una tarea determinada y cuánto estamos dispuestos a pagar por ella.
En este artículo voy a analizar qué son GPT-6 Sol y Luna, sus diferencias, precios, rendimiento, mejoras en programación y fiabilidad y, sobre todo, cuándo tiene sentido utilizar Luna, cuándo Sol y cuándo merece la pena subir hasta Astra.
Qué son GPT-6 Sol y GPT-6 Luna
GPT-6 Sol y GPT-6 Luna son dos modelos de la familia GPT-6 situados por debajo de GPT-6 Astra, el modelo más potente de esta generación.
La idea no parece ser crear simplemente tres modelos con más o menos inteligencia, sino ofrecer diferentes puntos dentro de una misma escala de capacidad, velocidad y coste.
OpenAI explica que Sol y Luna utilizan avances procedentes de la misma generación tecnológica de Astra, trasladando mejoras en áreas como programación, factualidad, trabajo profesional y uso del ordenador hacia modelos más económicos.
Eso permite entender mejor para qué existe cada uno.
Dónde encajan Sol y Luna dentro de la familia GPT-6
Yo lo simplificaría así:
| Modelo | Papel principal |
|---|---|
| GPT-6 Luna | Operaciones rápidas, repetitivas y de gran volumen |
| GPT-6 Sol | Trabajo complejo donde importa equilibrar capacidad y coste |
| GPT-6 Astra | Problemas donde buscamos la máxima capacidad disponible |
Esta distinción me parece especialmente importante porque rompe con una costumbre que hemos tenido durante varias generaciones de modelos: asumir que lo lógico es utilizar siempre el más potente que podamos permitirnos.
No necesariamente.
Si una tarea puede resolverse de forma fiable con Luna, utilizar Astra probablemente sea un desperdicio de recursos. Y si Sol puede resolver correctamente una tarea de programación o razonamiento, tampoco tenemos por qué escalar automáticamente al modelo superior.
Por qué OpenAI necesita varios niveles de modelos
La explicación está en cómo funcionan las aplicaciones reales.
Una persona puede realizar veinte consultas al día y apenas notar la diferencia económica entre utilizar uno u otro modelo. Pero una empresa puede enviar cientos de miles o millones de solicitudes.
En ese escenario, cada céntimo cuenta.
Por eso creo que la familia GPT-6 hay que entenderla menos como una clasificación de bueno, mejor y excelente y más como una caja de herramientas.
No utilizaríamos una excavadora para plantar una maceta simplemente porque es una máquina más potente. Con los modelos de IA sucede algo parecido.
Y probablemente veremos cada vez más sistemas que seleccionen automáticamente Luna, Sol o Astra dependiendo de la dificultad de cada petición.
GPT-6 Sol vs Luna: principales diferencias
La diferencia entre GPT-6 Sol y GPT-6 Luna no consiste simplemente en que Sol sea “mejor”.
Su propósito es diferente.
Sol está orientado hacia trabajos que requieren más razonamiento, programación, utilización de herramientas o ejecución de tareas complejas durante varios pasos.
Luna, en cambio, tiene mucho sentido cuando necesitamos resolver una tarea clara muchas veces y queremos minimizar latencia y coste.
GPT-6 Sol: más capacidad para razonamiento, programación y agentes
GPT-6 Sol me parece probablemente el punto más interesante de la familia para desarrolladores y usuarios técnicos.
Hay muchísimas tareas que ya son demasiado complejas para querer ejecutarlas siempre con el modelo más ligero, pero que tampoco justifican recurrir continuamente a Astra.
Por ejemplo:
- programación y revisión de código;
- depuración;
- análisis de información;
- agentes con varios pasos;
- automatizaciones complejas;
- tareas profesionales donde existe bastante contexto;
- procesos donde necesitamos mayor fiabilidad factual.
Ahí Sol ocupa una posición muy atractiva.
No busca necesariamente derrotar a Astra en capacidad absoluta. Su propuesta es otra: ofrecer suficiente inteligencia para resolver una proporción muy alta del trabajo técnico manteniendo un coste mucho más fácil de escalar.
GPT-6 Luna: velocidad y eficiencia para tareas de gran volumen
Luna es todavía más interesante si cambiamos la perspectiva.
En lugar de preguntarnos cuánto razonamiento máximo puede ofrecer, podemos preguntarnos:
¿Cuántas tareas sencillas necesito resolver al día?
Si tenemos que clasificar 500.000 comentarios, extraer determinados datos de documentos, resumir textos, identificar categorías o responder preguntas relativamente directas, la capacidad adicional de un modelo superior puede aportar poco valor.
En mi caso, ahí es donde más sentido encuentro a Luna.
No necesito que cada clasificación se convierta en un ejercicio profundo de razonamiento. Necesito que el resultado sea suficientemente bueno, rápido y barato.
Eigent resume una estrategia parecida al plantear Luna para trabajos definidos y de alto volumen, mientras reserva Sol para programación y procesos agénticos más exigentes.
Y esa diferencia puede parecer pequeña cuando hacemos diez peticiones.
Cuando hacemos diez millones, deja de serlo.
GPT-6 Astra vs Sol vs Luna: qué cambia entre los tres modelos
La pregunta realmente útil no es cuál de los tres modelos es “el mejor”, porque sabemos que Astra ocupa la parte superior de la familia.
La pregunta es:
¿cuál necesito para esta tarea concreta?
Cuándo tiene sentido utilizar Astra
Astra tiene sentido cuando la dificultad del problema pesa considerablemente más que el coste.
Por ejemplo, trabajos especialmente complejos, tareas largas de uso del ordenador, problemas donde necesitamos llevar el razonamiento lo más lejos posible o situaciones donde una respuesta incorrecta puede obligarnos a repetir un proceso muy caro.
OpenAI sigue posicionando Astra como su opción de máxima capacidad.
Eso no significa que deba ser el modelo por defecto.
De hecho, creo que la existencia de Sol y Luna hace precisamente menos necesario utilizar Astra constantemente.
Cuándo elegir Sol
Yo elegiría Sol cuando la tarea exige suficiente razonamiento como para que los errores o una respuesta superficial empiecen a resultar caros.
Programación es el ejemplo más evidente.
Si estoy pidiendo a un modelo que modifique una base de código, revise una implementación o ejecute varios pasos utilizando herramientas, prefiero gastar algo más si eso reduce la cantidad de trabajo que luego tengo que revisar.
Sol también tiene sentido en:
- análisis complejos;
- agentes;
- investigación;
- tareas profesionales multietapa;
- automatizaciones donde intervienen varias herramientas;
- generación de código que después llegará a producción.
Cuándo elegir Luna
Luna encaja cuando la tarea es más predecible:
- resumir;
- etiquetar;
- clasificar;
- extraer campos;
- reformatear información;
- enrutar solicitudes;
- responder preguntas sencillas;
- procesamiento masivo de documentos.
Y creo que esto es importante: usar Luna no significa conformarse con un modelo malo.
Significa asignar los recursos correctos al problema.
La lógica que yo utilizaría sería la siguiente:
Luna primero cuando el problema sea sencillo, Sol cuando necesitemos razonamiento adicional y Astra cuando el coste de quedarse corto supere claramente el coste adicional del modelo.
Precio de GPT-6 Sol y Luna: por qué la eficiencia importa tanto como la inteligencia
Aquí está probablemente una de las novedades más importantes de GPT-6.
Los precios de API anunciados por OpenAI son:
| Modelo | Entrada / 1M tokens | Salida / 1M tokens |
|---|---|---|
| GPT-6 Sol | $2 | $10 |
| GPT-6 Luna | $0,10 | $0,50 |
| GPT-5.6 Sol | $4 | $20 |
| GPT-5.6 Luna | $0,20 | $1,20 |
Esto supone reducir a la mitad tanto la entrada como la salida de Sol. En Luna, la entrada también cae un 50 %, mientras que la salida pasa de $1,20 a $0,50, una reducción de aproximadamente el 58 %.
Diferencias de precio frente a GPT-5.6
Mirando únicamente una conversación, estos números pueden parecer poco importantes.
Pero creo que sería un error analizarlos así.
Una empresa que desarrolla una aplicación basada en IA no está pensando únicamente en cuánto cuesta una respuesta.
Está pensando en:
cuánto cuesta multiplicar esa respuesta por un millón.
Y ahí una reducción cercana a la mitad cambia completamente las matemáticas.
Esto puede permitir aumentar el número de pasos de un agente, procesar documentos que antes no resultaban rentables, ofrecer límites de uso mayores o simplemente mejorar los márgenes de un producto construido alrededor de la API.
Coste por token frente a coste real por tarea
Aquí hay otro matiz importante.
El precio por millón de tokens es útil para comparar modelos, pero el coste por tarea es probablemente una métrica más interesante.
Imaginemos dos modelos:
- el modelo A cuesta la mitad por token;
- el modelo B necesita un 40 % menos de tokens y termina correctamente el trabajo con menos intentos.
Puede que B acabe siendo más barato.
Por eso no elegiría Luna automáticamente solo porque su tarifa nominal sea menor.
Hay que medir:
- tokens consumidos;
- cantidad de reintentos;
- errores;
- tiempo de ejecución;
- revisiones humanas necesarias;
- porcentaje de tareas completadas correctamente.
Ahí descubrimos el precio real de utilizar un modelo.
Por qué una pequeña diferencia importa a gran escala
Esta es una de las partes del lanzamiento que más me interesa.
Cuando una aplicación procesa miles o millones de peticiones, una reducción de coste puede acabar teniendo más importancia que unos cuantos puntos adicionales en un benchmark.
Además, OpenAI ha mejorado el prompt caching de GPT-6 y anuncia descuentos del 90 % sobre las lecturas de tokens de entrada que pueden reutilizarse desde caché. Esto resulta especialmente relevante para agentes y conversaciones largas donde una parte considerable del contexto se repite.
En otras palabras, optimizar el modelo ya no consiste únicamente en escoger Sol o Luna.
También consiste en diseñar correctamente cómo utilizamos el contexto.
Rendimiento y benchmarks de GPT-6 Sol y Luna
Los benchmarks son importantes, pero intento mirarlos con cierta distancia.
Son útiles para identificar tendencias. El problema aparece cuando convertimos una diferencia de unos cuantos puntos en la conclusión definitiva de que un modelo es mejor para absolutamente todo.
OpenAI ha publicado resultados de GPT-6 Sol y Luna en pruebas de agentes, programación, factualidad y uso del ordenador. En conjunto, el argumento de esta generación está menos centrado en conseguir una diferencia gigantesca de capacidad y más en obtener resultados competitivos reduciendo el coste por tarea.
Rendimiento en agentes y tareas profesionales
Sol parece especialmente pensado para este terreno.
Los agentes necesitan razonar, utilizar herramientas, mantener contexto, detectar cuándo algo falla y decidir cuál es el siguiente paso.
Eso es bastante diferente de responder a una pregunta independiente.
También es donde el coste empieza a importar enormemente, porque un único encargo del usuario puede generar decenas de llamadas internas al modelo.
Si cada paso utiliza Astra, el coste se multiplica rápidamente.
Utilizar Luna en pasos triviales y Sol en los que requieren razonamiento puede ser mucho más eficiente.
Programación y generación de código
Las pruebas publicadas también apuntan a mejoras en programación.
Pero aquí personalmente prefiero evitar una lectura simplista del tipo:
“nuevo modelo = programa mejor”.
DataCamp hizo una prueba interesante creando un visualizador del algoritmo de Dijkstra. Los modelos resolvieron bastante bien la parte convencional, pero la diferencia apareció cuando el conjunto de datos contenía un peso negativo que hacía inadecuado aplicar el algoritmo tal como se había solicitado: GPT-6 Sol fue el que reaccionó de forma más contundente deteniendo la ejecución en lugar de limitarse a producir una salida aparentemente válida.
Me parece un ejemplo útil porque demuestra algo que los benchmarks tradicionales no siempre capturan bien:
saber cuándo no debemos producir una respuesta puede ser tan importante como saber producirla.
Uso del ordenador y automatización
Astra continúa situado en la parte superior para las tareas más exigentes de computer use, mientras que Sol y Luna buscan ofrecer una relación entre rendimiento y coste más favorable para cargas menos extremas.
Aquí creo que veremos mucho routing dinámico.
Un agente puede utilizar Luna para leer y clasificar información, Sol para decidir qué debe hacer y reservar Astra únicamente para una subtarea especialmente difícil.
Por qué los benchmarks no cuentan toda la historia
Personalmente, más allá de quién consiga aparecer primero en una tabla determinada, me interesa comprobar cómo se comportan estos modelos trabajando durante horas con tareas reales.
Ahí suelen aparecer diferencias que un benchmark aislado no refleja:
- pérdida de contexto;
- errores acumulativos;
- decisiones equivocadas;
- uso incorrecto de herramientas;
- incapacidad para corregirse;
- reintentos innecesarios;
- generación de respuestas plausibles pero falsas.
Un modelo que obtiene un punto menos en un benchmark pero necesita muchas menos correcciones podría acabar siendo mucho más útil.
Por eso tomaría los benchmarks como una señal, no como el veredicto final.
GPT-6 Sol mejora en fiabilidad y errores factuales
Esta puede ser una de las mejoras más importantes de toda la generación.
Uno de los mayores problemas que seguimos teniendo con la inteligencia artificial no es que los modelos sean incapaces de responder.
Es justo lo contrario:
pueden responder con muchísima seguridad incluso cuando están equivocados.
OpenAI afirma que, en su evaluación interna basada en conversaciones donde los usuarios habían señalado errores factuales, GPT-6 Sol comete aproximadamente la mitad de errores que GPT-5.6 Sol. La propia compañía advierte, eso sí, que ese conjunto está construido a partir de conversaciones problemáticas y no representa la frecuencia normal de errores en ChatGPT.
Ese matiz importa.
No significa que Sol vaya a equivocarse “la mitad de veces” en cualquier tarea imaginable.
Significa que, dentro de esa evaluación concreta, la mejora observada es importante.
El problema de las respuestas convincentes pero incorrectas
Para mí, esta cuestión afecta directamente a la productividad.
Si utilizo un modelo para preparar un texto y tengo que comprobar cada dato que proporciona, el ahorro de tiempo se reduce.
Si genero código y tengo que revisar constantemente si ha inventado una API, interpretado mal una función o solucionado un problema distinto del que le pedí, ocurre lo mismo.
La fiabilidad tiene un valor económico.
No aparece directamente en la tarifa por token, pero sí aparece en las horas que invertimos revisando lo generado.
Por qué reducir errores puede importar más que ganar benchmarks
Supongamos que un nuevo modelo obtiene solamente un 2 % más en una prueba de programación.
Eso resulta interesante.
Pero imaginemos que además reduce de forma apreciable el número de ocasiones en las que afirma haber completado correctamente una tarea cuando en realidad no lo ha hecho.
Para un equipo que utiliza agentes de programación diariamente, la segunda mejora puede tener muchísimo más valor.
Por eso uno de los aspectos que seguiría con mayor atención en GPT-6 Sol no es únicamente cuánto código genera, sino cuándo reconoce que algo está mal, cuándo se detiene y cuándo pide información adicional en lugar de inventarla.
GPT-6 Sol para programación y agentes de IA
Creo que programación es uno de los terrenos donde Sol tiene más posibilidades de convertirse en el modelo de referencia dentro de esta familia.
No porque vaya a sustituir siempre a Astra, sino porque programar con IA implica ejecutar el modelo muchas veces.
Un agente puede:
- leer varios archivos;
- entender la arquitectura;
- buscar referencias;
- escribir código;
- ejecutar pruebas;
- detectar un fallo;
- modificar la implementación;
- volver a ejecutar las pruebas;
- revisar el resultado.
Una petición humana puede transformarse fácilmente en numerosas interacciones con el modelo.
Por eso el coste por llamada y el coste por tarea terminan teniendo tanta importancia.
Generar más código no siempre significa ser más productivo
Hay una idea que para mí merece bastante más atención.
Un modelo puede generar código a toda velocidad y, aun así, hacernos perder tiempo.
Si introduce errores constantemente, necesitamos revisar cada línea con enorme cuidado. Entonces parte de la productividad prometida desaparece.
La métrica real debería acercarse más a:
¿cuánto trabajo correcto y aprovechable produce antes de necesitar intervención humana?
Por eso me interesa especialmente la combinación de mejores capacidades de programación y mayor factualidad que OpenAI atribuye a Sol.
Un agente que sabe programar pero no sabe reconocer sus propios fallos sigue siendo bastante limitado.
El impacto de la fiabilidad en agentes autónomos
Cuando utilizamos un chatbot convencional, podemos detectar una respuesta extraña y simplemente ignorarla.
Con un agente autónomo el problema cambia.
El modelo puede tomar una decisión incorrecta y utilizar esa decisión como entrada para el siguiente paso.
El error se propaga.
Por eso, cuanto más autónomo es un sistema, más importantes se vuelven, algo que aplicamos directamente al diseñar Hermes Agent como agente autoalojado:
- validación;
- permisos;
- observabilidad;
- límites;
- revisión de acciones críticas;
- recuperación ante errores.
Y aquí tampoco asumiría que un modelo más avanzado elimina la necesidad de diseñar estas protecciones.
La fiabilidad del modelo ayuda, pero la infraestructura debe seguir poniendo límites.
GPT-6 Luna para clasificación, extracción y tareas repetitivas
Luna juega un papel diferente.
Si Sol me parece especialmente interesante como modelo general para trabajo técnico, Luna me parece muy atractivo como motor de procesamiento masivo.
Hay miles de aplicaciones donde no necesitamos una IA reflexionando profundamente durante cada petición.
Necesitamos consistencia.
Por ejemplo:
- clasificar un ticket de soporte;
- detectar el tema principal de un comentario;
- extraer nombre, fecha e importe de un documento;
- resumir una conversación;
- transformar información a JSON;
- determinar a qué flujo debe enviarse una consulta;
- generar descripciones sencillas;
- etiquetar grandes conjuntos de datos.
Cuándo utilizar un modelo pequeño tiene más sentido
A veces hablamos de los modelos pequeños como si fueran simplemente una alternativa de segunda categoría.
Creo que es una forma equivocada de verlo.
Si Luna resuelve correctamente una tarea determinada, utilizar un modelo veinte veces más caro no hace que esa tarea esté veinte veces mejor resuelta.
La solución eficiente consiste en encontrar el modelo mínimo que alcanza el nivel de calidad que necesitamos.
Y si no lo alcanza, escalamos.
Luna como opción para aplicaciones con miles o millones de peticiones
Este enfoque cobra todavía más sentido cuando hay volumen.
La salida de GPT-6 Luna cuesta oficialmente $0,50 por millón de tokens, frente a $10 en Sol.
Esa diferencia permite diseñar arquitecturas completamente distintas.
Podemos utilizar Luna en el 80 o 90 % de operaciones rutinarias y enviar únicamente los casos ambiguos a Sol.
Entonces la pregunta deja de ser:
“¿Sol o Luna?”
y pasa a ser:
“¿qué porcentaje de mi carga realmente necesita Sol?”
Para mí, esa segunda pregunta es mucho más interesante.
Qué modelo GPT-6 elegir según la tarea
Si tuviera que convertir toda la comparación en una guía práctica, empezaría por la dificultad y el coste del error.
| Tarea | Modelo que probaría primero |
|---|---|
| Clasificación masiva | Luna |
| Extracción estructurada | Luna |
| Resúmenes sencillos | Luna |
| Enrutamiento de consultas | Luna |
| Chat de gran volumen | Luna |
| Programación | Sol |
| Revisión y depuración de código | Sol |
| Agentes multietapa | Sol |
| Análisis complejo | Sol |
| Trabajo profesional con alta carga factual | Sol |
| Problemas excepcionalmente difíciles | Astra |
| Tareas donde el coste del error es muy elevado | Astra, con validación adicional |
No tomaría esta tabla como una regla rígida.
La utilizaría como punto de partida para experimentar.
Luna para operaciones rápidas y de alto volumen
Empezaría con Luna cuando:
- el formato esperado está bien definido;
- la tarea es repetitiva;
- puedo verificar automáticamente el resultado;
- necesito procesar muchísimo volumen;
- una pequeña reducción de calidad es asumible.
Si funciona, no hay ninguna razón para escalar.
Sol para equilibrar capacidad, razonamiento y coste
Sol sería mi opción inicial cuando:
- existe ambigüedad;
- la tarea requiere varios pasos;
- intervienen herramientas;
- estoy trabajando con código;
- necesito más razonamiento;
- los errores empiezan a ser caros.
Creo que precisamente este equilibrio puede convertirlo en uno de los modelos más utilizados de la generación GPT-6.
Astra para los problemas más exigentes
Utilizaría Astra cuando haya probado Sol y la diferencia de calidad justifique económicamente el salto.
Ese último punto es importante.
No deberíamos decidir solamente mirando una tabla de benchmarks.
La prueba relevante es nuestro propio flujo de trabajo.
Si Astra reduce un 30 % los errores en una tarea crítica, probablemente compense.
Si la diferencia real es prácticamente imperceptible, Sol puede ser mucho más racional.
La verdadera novedad de GPT-6 puede ser utilizar automáticamente el modelo adecuado
Aquí es donde creo que esta generación se vuelve realmente interesante.
Probablemente el futuro de la inteligencia artificial no consista en que nosotros seleccionemos manualmente un modelo antes de cada conversación.
Lo lógico es que esa decisión desaparezca progresivamente.
El sistema puede analizar la petición y decidir:
- esto es trivial → Luna;
- esto necesita razonamiento → Sol;
- esto es excepcionalmente complejo → Astra.
Incluso una misma tarea podría pasar por los tres.
Routing entre Luna, Sol y Astra
Imaginemos un agente encargado de analizar 100.000 incidencias de clientes.
Luna puede:
- clasificar las incidencias;
- extraer datos;
- identificar duplicados;
- resumir cada caso.
Sol puede recibir únicamente:
- casos ambiguos;
- reclamaciones complejas;
- situaciones que necesitan razonamiento;
- peticiones que requieren utilizar varias herramientas.
Y Astra puede reservarse para un pequeño porcentaje de casos particularmente difíciles.
Este diseño puede ofrecer una calidad muy cercana a utilizar siempre un modelo grande con un coste radicalmente inferior.
Eigent plantea precisamente un patrón de routing similar entre Luna, Sol y Astra.
Por qué el futuro no pasa necesariamente por usar siempre el modelo más potente
Cuanto más madura la IA, menos sentido veo en evaluar los sistemas solamente por cuál tiene el modelo individual más inteligente.
Una aplicación bien diseñada puede ser mejor que otra incluso utilizando modelos menos potentes.
Puede:
- seleccionar mejor el modelo;
- utilizar herramientas correctamente;
- cachear contexto;
- verificar resultados;
- reintentar solo cuando sea necesario;
- escalar los problemas difíciles.
Por eso creo que GPT-6 Sol y Luna podrían terminar teniendo incluso más importancia para el ecosistema que Astra.
Astra demuestra dónde está la frontera.
Sol y Luna permiten llevar una parte mucho mayor de esa capacidad a aplicaciones que tienen que funcionar de forma rentable todos los días.
Disponibilidad y acceso a GPT-6 Sol y Luna
A fecha del 24 de septiembre de 2026, OpenAI indica que GPT-6 Sol y Luna están disponibles mediante la API con los identificadores:
gpt-6-solgpt-6-luna
También están llegando a ChatGPT Work y Codex para usuarios Plus, Pro, Business, Enterprise y Edu. OpenAI indica además que los usuarios Free y Go disponen de Luna en la aplicación de escritorio y que el despliegue de estos modelos se está realizando de forma gradual.
Uso mediante API
La API es probablemente donde la diferencia entre Sol y Luna resulta más interesante.
En una conversación individual podemos cambiar de modelo dependiendo de lo que queremos hacer.
En una aplicación, en cambio, podemos automatizar esa decisión.
Podemos programar un sistema para empezar con Luna y escalar a Sol si:
- la respuesta tiene baja confianza;
- falla una validación;
- el problema pertenece a determinada categoría;
- necesitamos utilizar herramientas;
- aparecen varias etapas de razonamiento.
Eso permite optimizar coste sin depender de que el usuario piense constantemente qué modelo seleccionar.
Acceso dentro del ecosistema de OpenAI
La integración con herramientas orientadas al trabajo y la programación también refuerza el papel de Sol.
Tiene bastante sentido que un modelo pensado para agentes, código y procesos profesionales aparezca especialmente ligado a superficies donde puede ejecutar trabajos completos, mientras Luna cubre el extremo de mayor volumen y menor coste.
Lo importante será observar cómo evoluciona esta separación.
Porque mi impresión es que, con el tiempo, probablemente veremos menos nombres de modelos en las interfaces y más selección automática según la tarea.
Sol y Luna podrían ser más importantes de lo que parecen
GPT-6 Astra es, inevitablemente, el modelo que más llama la atención.
Representa el máximo nivel de esta generación y sirve como referencia de lo que OpenAI puede conseguir cuando prioriza la capacidad.
Pero GPT-6 Sol y Luna me parecen más interesantes desde el punto de vista del uso cotidiano.
Sol busca ocupar un terreno enorme: programación, agentes, razonamiento y trabajo profesional sin asumir constantemente el coste del modelo insignia.
Luna aborda otro mercado todavía mayor: los millones de pequeñas operaciones que no necesitan toda la inteligencia disponible.
Y ahí está, para mí, la idea fundamental de GPT-6.
La eficiencia empieza a ser casi tan importante como la inteligencia.
Cuando una empresa procesa millones de solicitudes, una reducción importante del coste puede tener mucho más efecto que conseguir unos pocos puntos adicionales en un benchmark.
Lo mismo sucede con la fiabilidad.
Un modelo que genera código rápidamente pero nos obliga a revisar continuamente errores no es necesariamente más productivo. Si Sol realmente consigue reducir de forma significativa las respuestas incorrectas y comportarse mejor cuando encuentra un problema que no puede resolver, esa mejora puede tener muchísimo más valor que otra subida espectacular en una gráfica.
Por eso tampoco creo que la historia de esta generación vaya a terminar en una comparación de Astra vs Sol vs Luna.
Lo más interesante será utilizarlos juntos.
Luna para velocidad y volumen. Sol para razonamiento y trabajo complejo. Astra para los problemas donde necesitamos llegar lo más lejos posible.
Probablemente el futuro de la inteligencia artificial no consista en utilizar siempre el modelo más potente disponible.
Consistirá en utilizar automáticamente el modelo adecuado para cada tarea.
Y si GPT-6 consigue avanzar de verdad en esa dirección reduciendo costes y aumentando la fiabilidad, Sol y Luna podrían acabar siendo dos de las piezas más importantes de toda esta generación.
Dudas de la comunidad
¿Cuál es la diferencia entre GPT-6 Sol y Luna?
GPT-6 Sol está pensado para trabajos que requieren más razonamiento, programación, agentes y procesos complejos. GPT-6 Luna prioriza velocidad y coste, por lo que resulta especialmente interesante para clasificación, extracción, resúmenes y otras operaciones repetitivas de gran volumen.
No lo plantearía como “Sol es bueno y Luna es peor”. Son dos niveles diseñados para necesidades distintas.
¿Qué modelo GPT-6 es mejor para programar?
Para programación empezaría generalmente por GPT-6 Sol.
Su posición dentro de la familia lo convierte en una opción lógica cuando necesitamos combinar razonamiento y generación de código sin recurrir constantemente a Astra.
Para tareas extraordinariamente complejas podemos escalar a Astra, mientras que Luna sigue siendo aprovechable para transformaciones o trabajos de código sencillos y repetitivos.
¿Cuándo debería utilizar GPT-6 Astra en lugar de Sol?
Cuando la dificultad del problema o el coste potencial de una mala respuesta justifiquen pagar más por acceder al nivel superior de la familia.
Mi enfoque sería comenzar con Sol, medir resultados y utilizar Astra cuando exista una mejora suficiente en nuestro caso concreto.
¿GPT-6 Luna sirve para resumir y extraer información?
Sí. Precisamente este tipo de operaciones bien definidas y de gran volumen son uno de los escenarios donde Luna tiene más sentido.
También puede utilizarse para clasificación, etiquetado, transformación de datos, enrutamiento de consultas y respuestas relativamente sencillas.
¿GPT-6 Sol y Luna son más baratos que GPT-5.6?
Sí.
GPT-6 Sol cuesta $2 por millón de tokens de entrada y $10 por millón de salida, frente a $4 y $20 en GPT-5.6 Sol.
GPT-6 Luna cuesta $0,10 de entrada y $0,50 de salida por millón de tokens, frente a $0,20 y $1,20 en GPT-5.6 Luna.
¿Se pueden utilizar GPT-6 Sol y Luna mediante API?
Sí. OpenAI ofrece ambos modelos mediante API como gpt-6-sol y gpt-6-luna.
Para aplicaciones reales, esta disponibilidad abre además la posibilidad de construir sistemas de model routing que asignen automáticamente cada petición a Luna, Sol o Astra dependiendo de su dificultad y coste esperado.
Opinión Personal
Mi impresión es que GPT-6 Sol y Luna pueden terminar siendo más importantes en el día a día que el propio Astra.
Astra representa el máximo nivel de capacidad, pero la mayoría de usuarios y empresas no necesitan utilizar siempre el modelo más potente disponible. En muchos casos, lo realmente importante es encontrar el equilibrio entre rendimiento, velocidad, fiabilidad y coste.
Ahí es donde veo especialmente interesante a Sol. Puede convertirse en una opción muy atractiva para programación, agentes y tareas complejas sin obligar a asumir constantemente el coste del modelo más avanzado. Luna, por su parte, me parece una solución muy lógica para clasificación, extracción de datos, resúmenes y procesos de gran volumen.
Para mí, la gran evolución no está únicamente en que los modelos sean más inteligentes. Está en que empezamos a tener una familia donde cada modelo puede desempeñar una función concreta.
Y creo que ese puede ser el verdadero futuro de la inteligencia artificial: no utilizar siempre el modelo más potente, sino usar automáticamente el modelo adecuado para cada tarea.
Ahora me interesa conocer tu opinión: ¿qué te parecen GPT-6 Sol y Luna? ¿Crees que usarías Sol, Luna o seguirías prefiriendo Astra para la mayoría de tareas? Déjame tu opinión en los comentarios.